Le Clustering
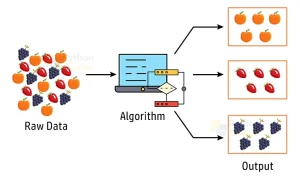
Définition : Le clustering, ou regroupement, consiste à partitionner des objets similaires en clusters. Ces grappes permettent d’identifier des tendances cachées dans les données.
Importance : Cette technique est essentielle pour simplifier l’analyse des données et faciliter la prise de décision, notamment en marketing pour cibler des segments de clients.
Types de Clustering :
- Clustering hiérarchique : Crée une hiérarchie de clusters.
- K-means : Partitionne en un nombre défini de groupes.
- DBSCAN : Basé sur la densité pour détecter des anomalies.
Méthodes : Les méthodes les plus courantes incluent la distance euclidienne et la distance manhattan. Des algorithmes d’apprentissage automatique complètent ces approches.
Outils Recommandés :
- Pandas : Pour la manipulation de données.
- Sci-kit Learn : Variété d’algorithmes d’apprentissage.
- R : Pour des analyses statistiques avancées.
Applications Pratiques :
- Analyse des clients dans le commerce 🛍️
- Segmentation d’images dans le traitement d’image 🖼️
- Détection d’anomalies en cybersécurité 🔒
| Aspects | Détails |
|---|---|
| Définition | Le clustering est une technique d’analyse de données permettant de regrouper des objets similaires en clusters. |
| Importance | Essentiel pour découvrir des structures cachées dans les données, facilitant la prise de décision. |
| Types |
|
| Méthodes | Utilisation de distances comme la distance euclidienne ou le manhattan pour mesurer la similarité. |
| Outils Recommandés |
|
| Applications |
|
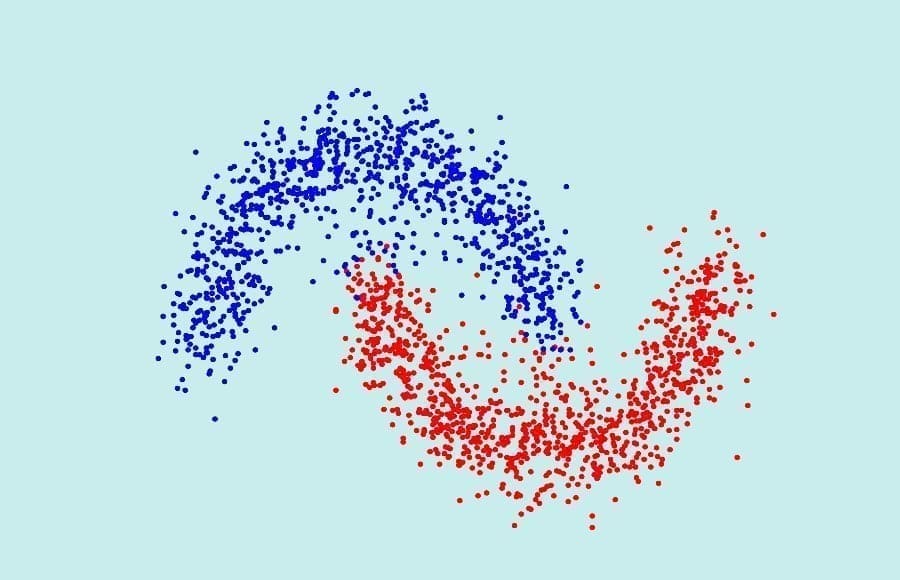
Le clustering représente une méthode précieuse dans le champ de l’analyse de données. En regroupant des objets similaires, cette technique permet d’identifier des tendances et des structures sous-jacentes au sein d’ensembles de données complexes. Comprendre le clustering, c’est plonger dans un monde où chaque donnée trouve sa place dans un tout cohérent. Cet article va décortiquer sa définition et explorer ses nombreuses applications.
Le Clustering : Comprendre sa Définition
Le clustering ou regroupement consiste à classer des éléments en groupes appelés clusters. Chaque cluster contient des objets partageant des attributs communs. Cette segmentation vise à simplifier l’analyse des données, facilitant ainsi la prise de décision éclairée.
À la source du clustering, on trouve une variété d’algorithmes qui interviennent pour diviser les données. En fonction de la nature des données, certaines méthodes sont plus appropriées que d’autres. Les techniques de clustering, comme le K-means ou le DBSCAN, apportent chacune leur approche unique pour catégoriser les informations.
Importance du Clustering en Analyse de Données
L’utilité du clustering se manifeste dans plusieurs domaines. Par exemple, dans le marketing, cette technique aide à détecter des segments de clients avec des comportements similaires. Ces insights permettent de personnaliser les campagnes et d’accroître l’efficacité des stratégies. Le clustering est aussi axé sur l’extraction d’informations cachées, un facteur clé pour transformer des données brutes en intelligence exploitables.
« Le clustering rend visible ce qui était invisible dans les données. Une vraie clé pour la décision stratégique. »
Types de Clustering : Variétés et Méthodes
Plusieurs types de clustering existent, chacun répondant à des enjeux spécifiques. Parmi les principales catégories, on retrouve :
- Clustering hiérarchique : Crée une hiérarchie de clusters en joignant progressivement les objets les plus similaires.
- K-means : Divise l’ensemble de données en un nombre déterminé de clusters, chaque point étant associé au cluster le plus proche.
- DBSCAN : Se basant sur la densité, cette méthode distingue les clusters et repère les anomalies comme du bruit.
Certaines méthodes utilisent également des algorithmes avancés et des techniques d’apprentissage automatique pour améliorer le processus de clustering. Choisir la bonne méthode dépend souvent des caractéristiques spécifiques de vos données.
Méthodes de Clustering
Pour réaliser un clustering efficace, plusieurs méthodes sont à votre disposition. Celles-ci intègrent des pratiques variées pouvant influencer le résultat :
| Méthode | Description | Utilisation |
|---|---|---|
| K-means | Partitionne les données en clusters définis | Analyse de marché, segmentation client |
| DBSCAN | Basé sur la densité, identifie les anomalies | Cybersécurité, détection de fraudes |
| Clustering hiérarchique | Création d’une hiérarchie de clusters | Analyse de données exploratoire |
Applications Pratiques du Clustering
Les applications du clustering sont aussi variées que nécessaires. En voici quelques-unes :
- Analyse de clients : Identifier les différents segments de clients permet d’ajuster les stratégies marketing.
- Sélection d’images : Utilisé dans le traitement d’images, pour regrouper des pixels similaires.
- Détection d’anomalies : Évalué dans la cybersécurité, le clustering aide à repérer des comportements inhabituels.
Ces exemples montrent comment le clustering facilite non seulement la gestion des données, mais aussi l’extraction d’insights précieux pour une variété d’industries.

Le clustering, ou regroupement, est une méthode incontournable dans le domaine de l’analyse de données. Elle permet de regrouper des ensembles d’objets similaires en formant des sous-groupes, appelés clusters. Cette technique est essentielle pour révéler des structures cachées au sein des données, facilitant ainsi leur compréhension et la prise de décision.
En marketing, par exemple, le clustering peut jouer un rôle clé dans l’identification de segments de clients partageant des comportements d’achat similaires. Cela permet aux entreprises d’optimiser leurs campagnes en ciblant des audiences spécifiques, augmentant ainsi leur efficacité. Grâce à cette méthodologie, les entreprises peuvent mieux adapter leurs offres aux besoins de différents segments de marché.
Il existe plusieurs types de clustering, tels que le clustering hiérarchique, qui forme une hiérarchie de clusters, et le K-means, qui partitionne des données en un nombre fixe de groupes. De plus, la méthode DBSCAN se concentre sur la densité des points pour identifier les clusters, améliorant ainsi la détection d’anomalies.
Pour mener à bien le clustering, il est essentiel d’utiliser des outils et logiciels appropriés, comme Pandas pour la manipulation des données, ou Sci-kit Learn qui offre divers algorithmes d’apprentissage automatique. Ces outils facilitent non seulement la mise en œuvre de la technique, mais permettent aussi d’affiner les résultats à l’aide de méthodes statistiques avancées.
Les applications du clustering sont nombreuses, allant de l’analyse des clients à la segmentation d’images et la détection d’anomalies en cybersécurité. En exploitant le potentiel du clustering, les entreprises et chercheurs peuvent transformer des données complexes en informations précieuses.